Comment passer de dizaines d’indicateurs de marque à quelques mesures facilitant les décisions ? Comment l’approche Stat & More®, avec le “pouvoir de marque” et la segmentation “amis de la marque”, transforme une matière abondante en outil de pilotage.
Du chiffre brut à la décision
Une étude de marque produit aujourd’hui une matière considérable : des dizaines d’indicateurs, des centaines de variables d’usage, des milliers d’associations entre marques et images, le tout répété vague après vague. Cette abondance est une chance et un risque. Sans synthèse, elle donne des tableaux de bord illisibles et des arbitrages qui finissent par reposer sur l’intuition, faute de savoir ce qui compte vraiment.
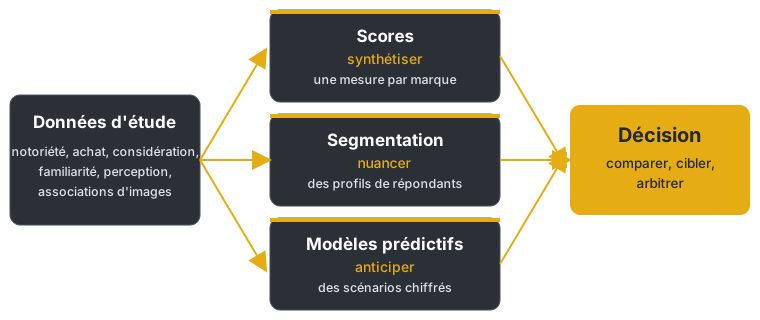
L’agrégation statistique est ce qui transforme cette matière en mesures utilisables. Elle ne consiste pas à faire des moyennes : elle cherche la structure cachée derrière les chiffres. Cet article poursuit, sur le plan des méthodes, notre série consacrée au capital de marque, à la disponibilité mentale et aux associations visuelles. Il présente trois familles d’outils :
- les scores, qui condensent plusieurs indicateurs en une mesure par marque,
- la segmentation, qui regroupe les répondants en profils homogènes,
- les modèles prédictifs, qui relient les perceptions aux comportements.
Pourquoi agréger
Multiplier les indicateurs sans les synthétiser ne fait pas mieux piloter : cela fait piloter plus difficilement. La valeur ne vient pas du nombre de chiffres, mais de la qualité de leur synthèse.
Pendant longtemps, les études de marque ont présenté leurs indicateurs côte à côte : 80 % de notoriété, 35 % de considération, 22 % d’achat, un NPS de +12. Ces présentations rassurent mais décident peu : elles laissent au lecteur le soin de pondérer lui-même les dimensions et de reconstituer la vue d’ensemble.
L’agrégation rend trois services. Elle permet de comparer rapidement un grand nombre de marques, souvent 15 à 25, sur quelques dimensions clés. Elle permet de cibler, en distinguant des profils de consommateurs qui n’obéissent pas à la même logique. Elle permet enfin de simuler l’effet d’un scénario avant d’engager un budget.
Elle a une autre vertu, moins visible : elle discipline la lecture. Quand chaque variable se commente isolément, il est tentant de mettre en avant celles qui confirment une intuition et de passer vite sur les autres. Quand l’analyse repose sur des scores définis à l’avance, ce tri devient beaucoup plus difficile. Agréger oblige à dire ce que l’on cherche, comment on le mesure et avec quelle précision.
Les scores latents : mesurer ce qu’on ne voit pas
Personne n’a jamais observé directement la force d’une marque. On en observe les manifestations : la marque est-elle connue, considérée, achetée, recommandée ? Un score latent reconstruit cette grandeur invisible à partir de ses manifestations mesurables. L’idée remonte à Charles Spearman, qui en 1904 inférait une aptitude générale à partir des résultats d’élèves à plusieurs épreuves.
Deux logiques à ne pas confondre
Avant tout calcul, il faut savoir dans quel sens va la relation entre le concept et ses indicateurs. Jarvis, MacKenzie et Podsakoff ont montré que cette question était très souvent mal traitée dans la recherche en marketing.
- Dans un modèle réflectif, le concept cause les indicateurs. L’attachement à une marque se reflète dans plusieurs questions qui varient ensemble : en retirer une ne change pas le sens de la mesure.
- Dans un modèle formatif, les indicateurs construisent le concept. Un indice qui combine notoriété, achat et considération additionne des composantes différentes : en retirer une change ce que l’on mesure.
La conséquence est pratique : la cohérence interne, que mesure l’alpha de Cronbach, n’a de sens que dans le premier cas. Exiger que la notoriété et l’achat soient fortement corrélés pour avoir le droit de les combiner serait un contresens.
Les grandes familles de méthodes
- L’analyse en composantes principales résume un ensemble d’indicateurs corrélés en quelques axes qui conservent l’essentiel de l’information.
- L’analyse factorielle suppose des facteurs communs sous-jacents et cherche à les identifier et à estimer le poids de chacun d’eux.
- Les modèles d’équations structurelles décrivent explicitement les relations entre concepts latents et indicateurs. L’approche PLS, à laquelle l’école française a beaucoup contribué (Tenenhaus et al., 2005), a l’avantage de traiter aussi les modèles formatifs.
- Les indices composites combinent des indicateurs normalisés selon des poids explicites.
La France a d’ailleurs une longue tradition dans ce domaine, celle de l’« analyse des données » de Jean-Paul Benzécri, prolongée aujourd’hui par des outils libres comme FactoMineR (Lê, Josse et Husson, 2008).
Les classements publiés par les grands cabinets, comme ceux d’Interbrand ou de Kantar BrandZ, reposent sur le même principe : combiner plusieurs mesures en un score comparable d’une marque à l’autre et d’une année sur l’autre.
Construire un score en quatre étapes
Le manuel de l’OCDE sur les indicateurs composites reste la référence la plus complète sur le sujet. Sa démarche se résume en quatre étapes :
- Choisir les indicateurs à partir d’un cadre théorique, et non parce qu’ils sont disponibles.
- Normaliser, pour qu’un indicateur ne domine pas le score uniquement parce que son échelle est plus large.
- Pondérer, soit par des poids fixés a priori, soit par des poids estimés à partir des données. Aucun choix n’est neutre : il doit être explicite.
- Valider : le score distingue-t-il bien des marques que l’on sait différentes ? Est-il lié aux résultats observés, comme la part de marché ? Reste-t-il stable si l’on modifie légèrement l’échantillon ou les poids ?
Pour les construits réflectifs, deux repères sont d’usage courant : un alpha de Cronbach d’au moins 0.7 et, dans les modèles structurels, une variance moyenne extraite d’au moins 0.5 (Fornell et Larcker, 1981). Ce sont des conventions, pas des lois.
Le « pouvoir de la marque » : notre score de synthèse
Chez Stat & More, la synthèse prend la forme d’un score que nous appelons pouvoir de la marque. Nous en avons présenté le principe et des exemples de restitution dans l’article Performance de Marque ; nous en détaillons ici la mécanique.
Les indicateurs de départ
Le score part de ce que mesure une étude de marque bien construite : notoriété spontanée et assistée, première marque citée, achat récent, familiarité, considération, perception globale. Les associations d’images, résumées par les scores de richesse et d’unicité, complètent la lecture en décrivant le territoire de la marque.
L’analyse discriminante linéaire, en clair
Pour combiner ces indicateurs, nous utilisons l’analyse discriminante linéaire, proposée par Ronald Fisher en 1936. Son principe est simple : on dispose de groupes connus à l’avance, et l’on cherche la combinaison des indicateurs qui les sépare le mieux.
Dans notre méthode, les groupes sont définis par le comportement : les acheteurs ou utilisateurs récents de la marque d’un côté, les autres répondants de l’autre. Le modèle apprend ce qui, dans les réponses, distingue les premiers des seconds. Il fournit ensuite, pour chaque répondant et chaque marque, une probabilité a posteriori : celle d’appartenir au groupe des acheteurs au vu de son profil de réponses.
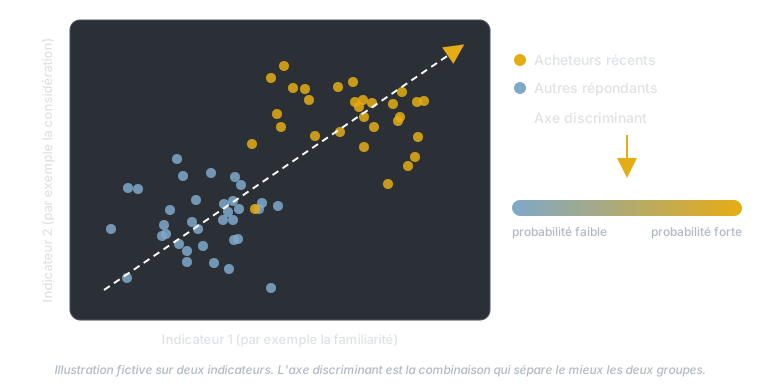
Le pouvoir de la marque est construit à partir de ces probabilités. Il répond à une question concrète : au vu de ce que les consommateurs pensent et savent de la marque, à quel point ressemblent-ils à ses acheteurs ?
Ce que ce choix apporte
- Des poids qui ne sont pas arbitraires : ils ne viennent ni d’une convention ni d’un avis d’expert, mais de ce qui sépare réellement acheteurs et non-acheteurs dans les données.
- Un score ancré dans le comportement : une marque très connue mais dont les perceptions ne distinguent pas les acheteurs n’obtient pas un score élevé pour sa seule notoriété.
- Une mesure nuancée : une probabilité dit plus qu’un classement en deux cases. Un non-acheteur dont le profil est proche de celui des acheteurs constitue un potentiel ; un acheteur dont le profil en est éloigné constitue une fragilité.
- Un score qui se décompose : on peut revenir aux indicateurs pour comprendre ce qui porte le score d’une marque et ce qui le freine.
Une précision de vocabulaire : le sigle LDA désigne ici l’analyse discriminante linéaire (Linear Discriminant Analysis). Il désigne aussi, dans nos autres articles, l’allocation de Dirichlet latente (Latent Dirichlet Allocation), que nous utilisons pour explorer les motifs d’associations. Ce sont deux méthodes différentes, pour deux usages différents.
Lire le score
Le pouvoir de la marque permet de situer 15 à 25 marques sur un même axe, puis de regarder ce qu’il y a derrière. Deux marques au score voisin peuvent avoir des structures opposées : l’une portée par la familiarité, l’autre par la considération. C’est cette décomposition qui fait d’un chiffre un diagnostic, et qui donne aux équipes études, marketing et direction générale un objet commun à discuter.
La segmentation : nuancer la moyenne
Un score par marque est une moyenne, et une moyenne cache presque toujours des écarts. Deux marques peuvent obtenir la même note en étant l’une consensuelle, l’autre très clivante. La segmentation regroupe les répondants en profils homogènes pour faire apparaître ces écarts.
Les méthodes
- Les centres mobiles (k-means) répartissent les répondants en un nombre de groupes fixé à l’avance.
- La classification ascendante hiérarchique regroupe de proche en proche et laisse choisir le nombre de groupes à la lecture de l’arbre.
- Les classes latentes attribuent à chaque répondant une probabilité d’appartenir à chaque profil.
Nous avons détaillé ces approches dans notre article sur la typologie.
Ce qui fait une bonne segmentation
Une segmentation statistiquement propre peut être inutilisable. Wedel et Kamakura retiennent six critères : des segments identifiables, de taille suffisante, accessibles par les actions marketing, stables dans le temps, qui réagissent différemment aux actions et qui orientent effectivement les décisions.
Les « amis de la marque » : une segmentation issue du même modèle
Dans nos dispositifs, nous utilisons une segmentation volontairement simple : les amis de la marque. Elle ne demande aucun modèle supplémentaire : elle sort de la même analyse discriminante que le pouvoir de la marque.
La définition
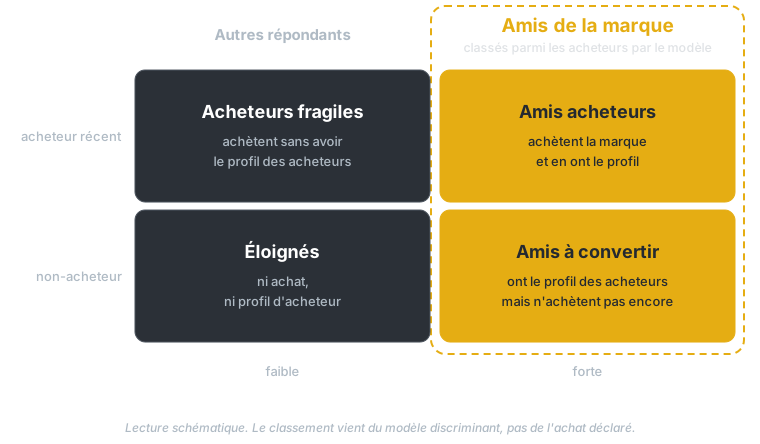
L’analyse discriminante attribue à chaque répondant, pour chaque marque, une probabilité a posteriori d’appartenir au groupe des acheteurs. Un ami de la marque est un répondant que le modèle classe dans ce groupe : au vu de sa familiarité, de sa considération, de sa perception et des autres indicateurs, il a le profil d’un acheteur de la marque.
La nuance est essentielle. L’achat réel sert à estimer le modèle, mais ce n’est pas lui qui définit l’ami : c’est le profil de réponses. Un répondant peut donc être un ami de la marque sans l’avoir achetée récemment, et un acheteur peut ne pas en être un.
Ce que le croisement révèle
Croiser le classement du modèle avec l’achat réel fait apparaître quatre situations :
- les amis acheteurs achètent la marque et en ont le profil : c’est le noyau,
- les amis à convertir ont tout du profil des acheteurs mais n’achètent pas encore. C’est le potentiel le plus direct, et le frein est à chercher ailleurs que dans la perception : distribution, prix, occasion d’achat,
- les acheteurs fragiles achètent sans avoir le profil des acheteurs, par habitude, pour le prix ou parce que la marque était disponible. Rien dans leurs perceptions ne les retient,
- les éloignés n’ont ni l’achat ni le profil.
Pourquoi elle fonctionne
Cette segmentation résume en une seule lecture l’ensemble des indicateurs de l’étude, pondérés par ce qui distingue réellement les acheteurs. Elle ne dépend pas d’un seuil fixé arbitrairement sur une question isolée, et elle reste cohérente avec le score de la marque puisqu’elle vient du même modèle.
Comparer les amis et les autres sur le reste de l’étude révèle ensuite ce qui les distingue : attribuent-ils à la marque des signes plus nombreux ? Plus exclusifs ? Sur quelles images l’écart est-il le plus grand ? Ces écarts désignent les leviers.
Ce qu’elle permet de décider
La part d’amis de chaque marque et son évolution posent un arbitrage classique : renforcer le noyau, ou élargir en convertissant les amis qui n’achètent pas encore et en gagnant de nouveaux profils ? Les travaux de l’Ehrenberg-Bass Institute, présentés dans notre article sur la disponibilité mentale, invitent à ne pas négliger le second terme : une marque grandit surtout en gagnant des acheteurs.
Les modèles prédictifs : relier perceptions et résultats
Le troisième outil relie les indicateurs de marque aux résultats que l’on veut atteindre : achat, recommandation, fidélité, part de marché.
Choisir selon ce que l’on veut prédire
- Pour un résultat en deux modalités (acheteur ou non, fidèle ou non), la régression logistique et l’analyse discriminante sont les points de départ naturels.
- Pour un résultat chiffré (une note, une intensité d’usage), la régression linéaire, éventuellement régularisée pour gérer des indicateurs très corrélés entre eux.
- Quand les effets ne sont pas linéaires ou se combinent, les forêts aléatoires et les méthodes voisines prennent le relais.
- Pour des données suivies dans le temps, les modèles de séries chronologiques.
Prédire n’est pas expliquer
Leo Breiman a décrit en 2001 deux cultures de la modélisation : l’une cherche à comprendre le mécanisme qui produit les données, l’autre à prédire le mieux possible. Les deux sont utiles, mais elles ne répondent pas à la même question. Un modèle qui prédit bien l’achat n’établit pas que modifier une perception modifiera l’achat. Nous avons consacré un article à cette différence entre corrélation et causalité.
Pour comprendre ce qui pèse dans un modèle complexe, les valeurs de Shapley attribuent à chaque variable sa contribution à la prédiction. Nous les comparons aux réseaux bayésiens dans notre article sur l’analyse de leviers.
Des associations aux variables explicatives
Les associations entre marques et images forment une matière très volumineuse. L’allocation de Dirichlet latente la résume en quelques thèmes interprétables, par exemple « fiabilité » ou « innovation », qui peuvent ensuite servir de variables explicatives. On réduit ainsi le nombre de variables tout en gardant des prédicteurs que l’on sait nommer.
De la prédiction à la simulation
L’intérêt d’un modèle est moins d’annoncer l’avenir que de comparer des scénarios : que peut-on attendre d’un gain de cinq points de notoriété spontanée ? D’un signe visuel mieux attribué à la marque ?
Ces simulations doivent rester honnêtes sur leur incertitude. Un modèle ne donne pas une valeur mais une fourchette, valable sous des hypothèses qu’il faut énoncer. Présenter les intervalles, signaler ce qui relève de l’extrapolation et tester d’autres hypothèses : c’est ce qui distingue un usage rigoureux d’une illusion de précision.
Les outils : reproductibilité avant tout
Ces analyses se mènent dans des environnements statistiques ouverts comme R ou Python. Tout ce qui est décrit ici y est disponible : composantes principales et analyses factorielles, équations structurelles, analyse discriminante, classifications, modèles prédictifs.
Le choix du logiciel compte moins que la façon de travailler. Une analyse sérieuse est reproductible : des scripts conservés et versionnés, un environnement figé, des traitements que l’on peut relancer à l’identique à la vague suivante, vérifier et étendre. C’est aussi ce qui rend possible l’automatisation des rapports.
Validation et limites
Valider, toujours
Aucun score, aucune segmentation, aucun modèle n’a de valeur sans validation :
- un score doit être lié aux indicateurs qu’il est censé résumer et distinguer les marques que l’on sait différentes,
- une segmentation doit se retrouver sur un autre échantillon ou à la vague suivante,
- un modèle prédictif se juge sur des données qu’il n’a pas vues, jamais sur celles qui ont servi à le construire.
Le rééchantillonnage et la validation croisée mesurent la stabilité des résultats. Ils évitent de prendre pour une structure ce qui n’est qu’un hasard d’échantillon.
Les limites
Un score de synthèse simplifie, c’est sa fonction : il ne dispense pas de revenir aux indicateurs. Une segmentation est une photographie, et les consommateurs changent de groupe. Un modèle très souple peut apprendre le bruit de l’échantillon au lieu de la tendance. Enfin, toutes ces méthodes travaillent sur des données déclaratives, avec leurs biais de mémoire et de désirabilité : les confronter à des données de comportement, quand elles existent, reste la meilleure vérification.
Envie de mettre l’agrégation statistique au service de votre marque ?
Si vous menez déjà des suivis de marque ou des études d’image, vous disposez probablement de la matière nécessaire pour passer d’une lecture descriptive à un pilotage structuré.
Chez Stat & More, nous accompagnons nos clients de bout en bout :
- De la conception des dispositifs de mesure à la structuration des bases de données.
- Du calcul des scores de synthèse (pouvoir de la marque, unicité, richesse) à la construction de segmentations utilisables (amis de la marque et déclinaisons).
- De la modélisation prédictive à la mise à disposition de tableaux de bord et de simulateurs qui facilitent les arbitrages.
Pour découvrir comment cette approche peut s’appliquer à vos enjeux, nous vous invitons à consulter notre site et à nous contacter :
- Site Stat & More : https://statandmore.com
- Présentation de Stat & More : https://statandmore.com/fr/blog/sam-presentation/
- Article “Performance de Marque” : https://statandmore.com/fr/blog/sam-brand_performance/
- Article “Fondations du Capital de Marque” : https://statandmore.com/fr/blog/sam-brandequity_01/
- Article “Disponibilité mentale et actif distinctif” : https://statandmore.com/fr/blog/sam-brandequity_02/
- Article “Associations visuelles et capital visuel de marque” : https://statandmore.com/fr/blog/sam-brandequity_03/
Vous souhaitez auditer un dispositif existant, en concevoir un nouveau ou structurer une démarche d’analyse adaptée à vos enjeux ? Contactez-nous dès aujourd’hui pour échanger sur vos enjeux et construire ensemble un dispositif d’analyse réellement utile au pilotage de votre marque.
Pour approfondir nos méthodologies d’études et d’analyse, retrouvez nos articles sur le blog Stat & More.
REFERENCES :
✔ Fisher, R. A. (1936). The Use of Multiple Measurements in Taxonomic Problems. Annals of Eugenics, 7(2), 179-188. https://doi.org/10.1111/j.1469-1809.1936.tb02137.x
✔ Spearman, C. (1904). “General Intelligence,” Objectively Determined and Measured. The American Journal of Psychology, 15(2), 201-292. https://doi.org/10.2307/1412107
✔ Jarvis, C. B., MacKenzie, S. B., & Podsakoff, P. M. (2003). A Critical Review of Construct Indicators and Measurement Model Misspecification in Marketing and Consumer Research. Journal of Consumer Research, 30(2), 199-218. https://doi.org/10.1086/376806
✔ Fornell, C., & Larcker, D. F. (1981). Evaluating Structural Equation Models with Unobservable Variables and Measurement Error. Journal of Marketing Research, 18(1), 39-50. https://doi.org/10.1177/002224378101800104
✔ OCDE & Centre commun de recherche de la Commission européenne (2008). Handbook on Constructing Composite Indicators: Methodology and User Guide. Éditions OCDE. https://doi.org/10.1787/9789264043466-en
✔ Contributeurs aux projets Wikipédia : Jean-Paul Benzécri. https://fr.wikipedia.org/wiki/Jean-Paul_Benz%C3%A9cri
✔ Tenenhaus, M., Esposito Vinzi, V., Chatelin, Y.-M., & Lauro, C. (2005). PLS path modeling. Computational Statistics & Data Analysis, 48(1), 159-205. https://doi.org/10.1016/j.csda.2004.03.005
✔ Lê, S., Josse, J., & Husson, F. (2008). FactoMineR: An R Package for Multivariate Analysis. Journal of Statistical Software, 25(1), 1-18. https://doi.org/10.18637/jss.v025.i01
✔ Wedel, M., & Kamakura, W. A. (2000). Market Segmentation: Conceptual and Methodological Foundations (2nd ed.). Springer. https://doi.org/10.1007/978-1-4615-4651-1
✔ Breiman, L. (2001). Statistical Modeling: The Two Cultures. Statistical Science, 16(3), 199-231. https://doi.org/10.1214/ss/1009213726
✔ Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning (2nd ed.). Springer. https://hastie.su.domains/ElemStatLearn/
✔ Lundberg, S. M., & Lee, S.-I. (2017). A Unified Approach to Interpreting Model Predictions. Advances in Neural Information Processing Systems, 30. https://proceedings.neurips.cc/paper/2017/hash/8a20a8621978632d76c43dfd28b67767-Abstract.html
✔ Blei, D. M., Ng, A. Y., & Jordan, M. I. (2003). Latent Dirichlet Allocation. Journal of Machine Learning Research, 3, 993-1022. https://www.jmlr.org/papers/volume3/blei03a/blei03a.pdf
Photo d'en-tête : Polar Cruises, Wikimedia Commons, licence CC BY 2.0. Image recadrée et redimensionnée.